shipped project
EvalBench
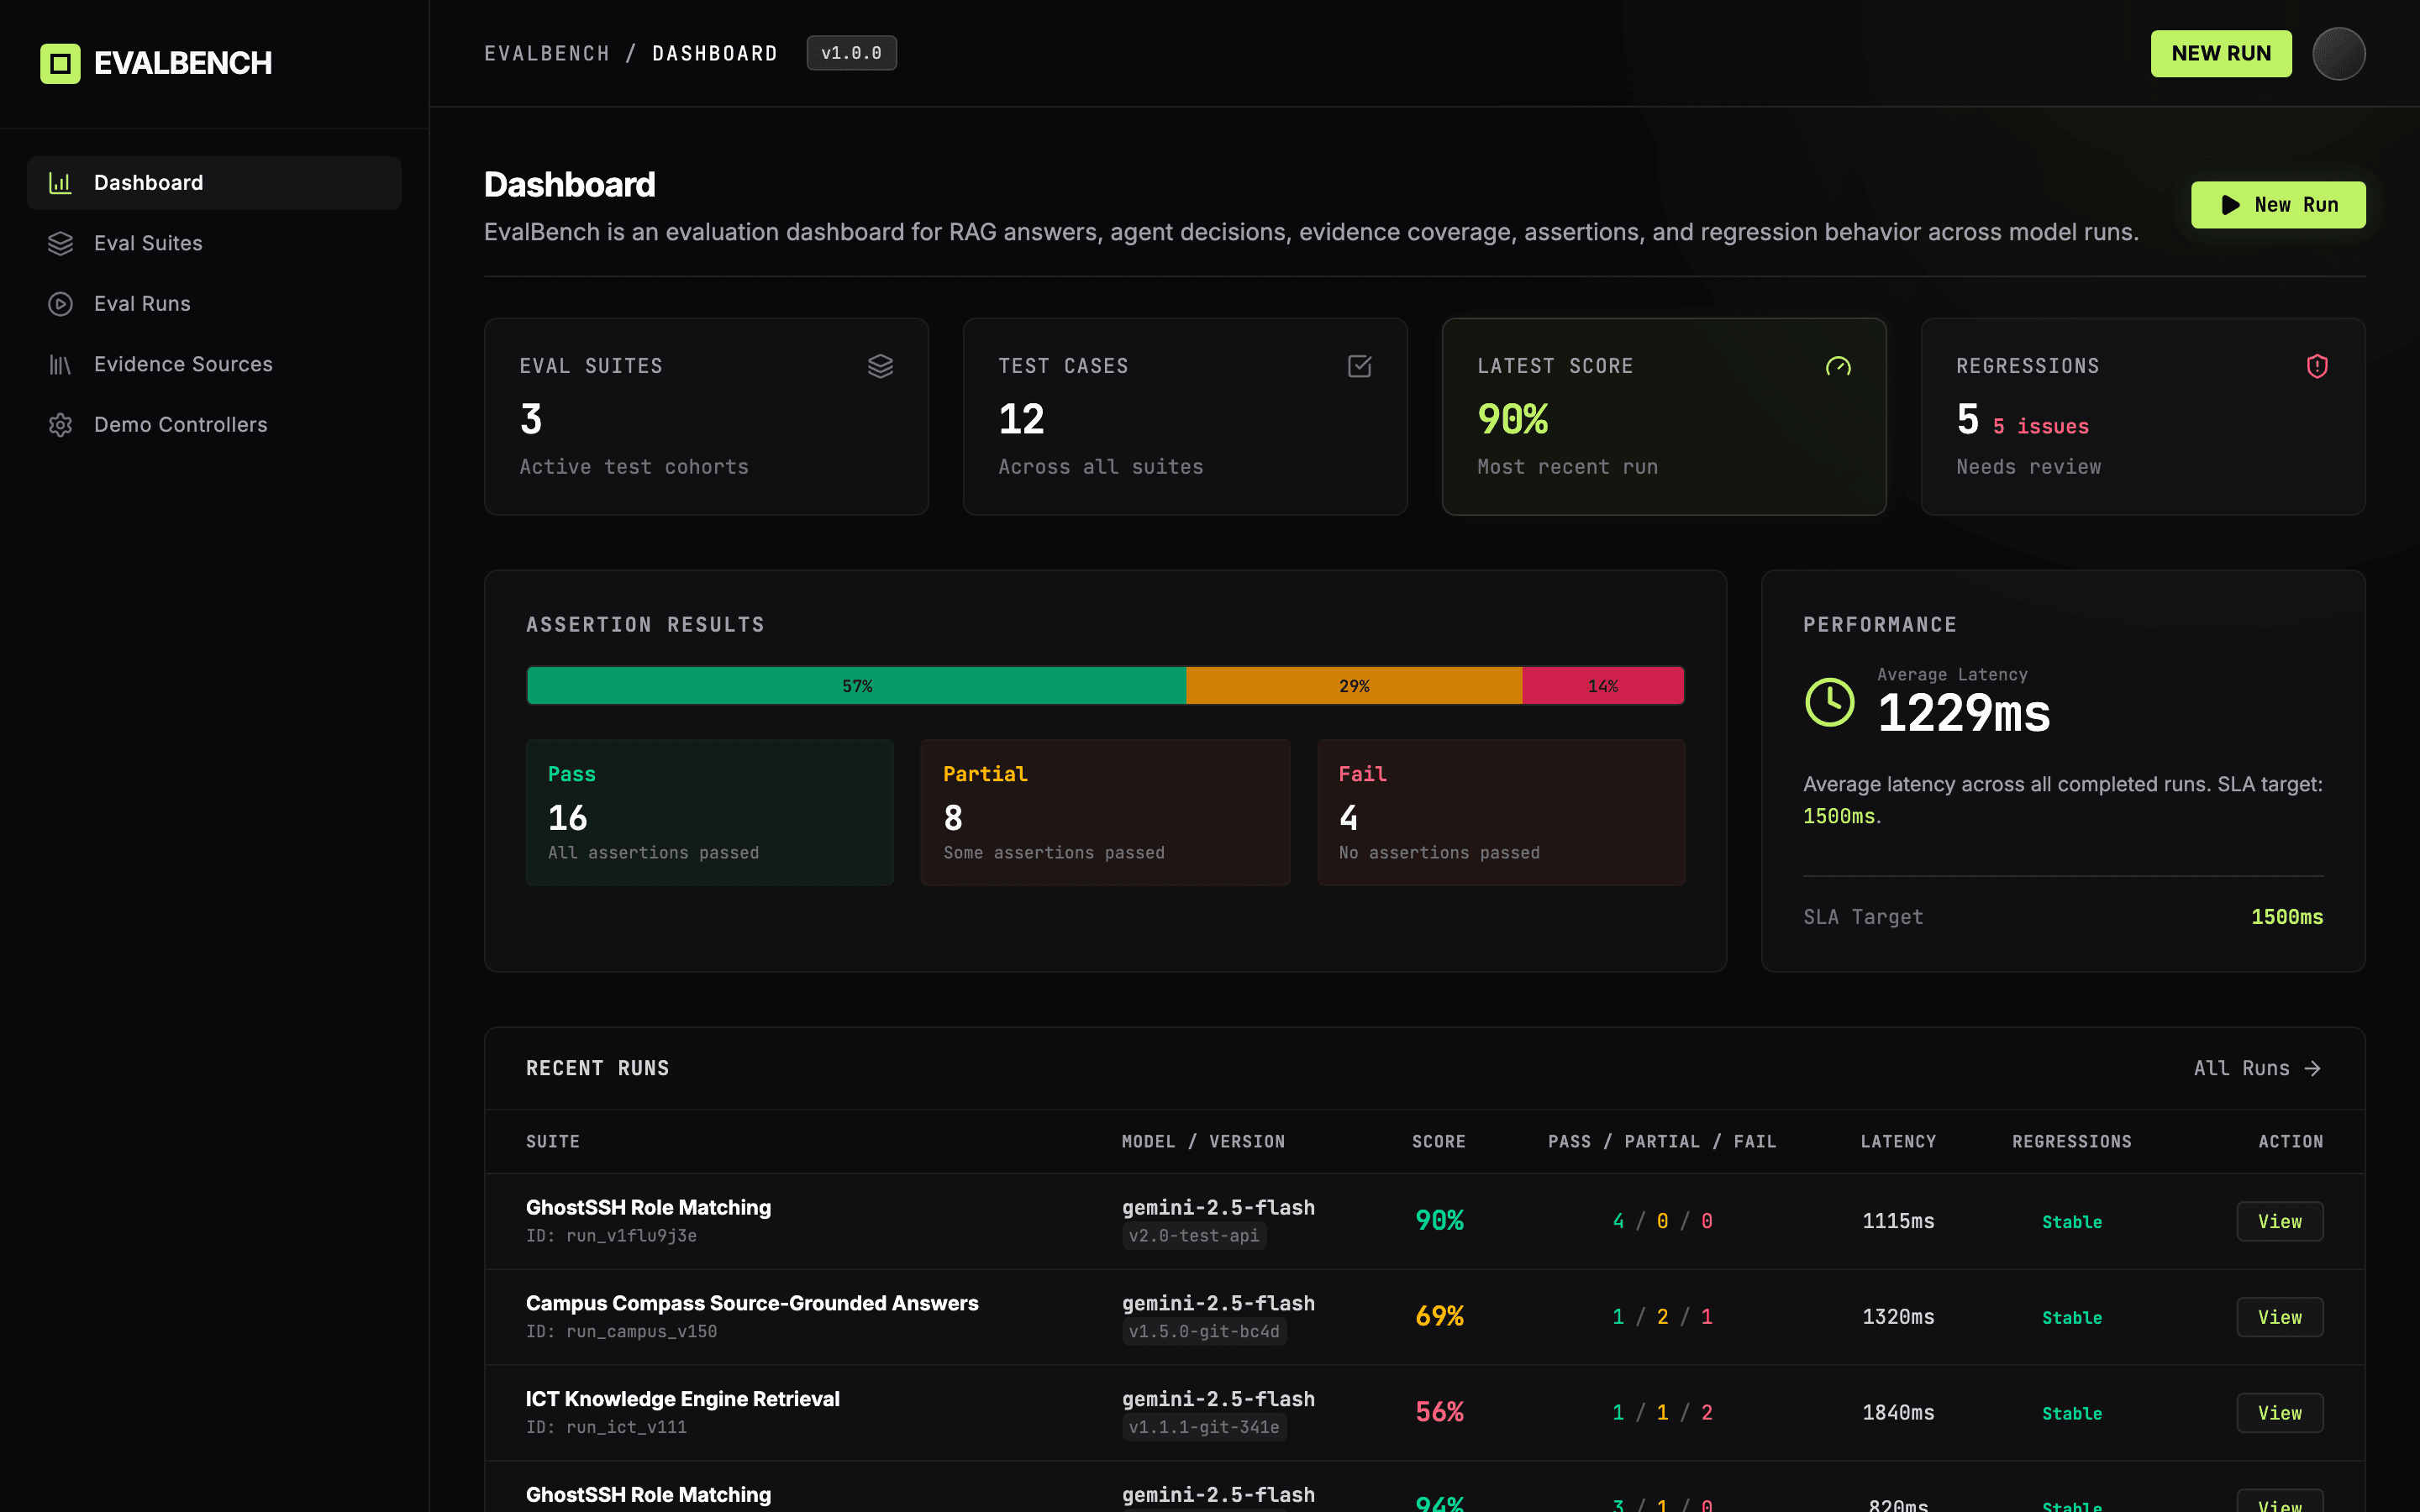
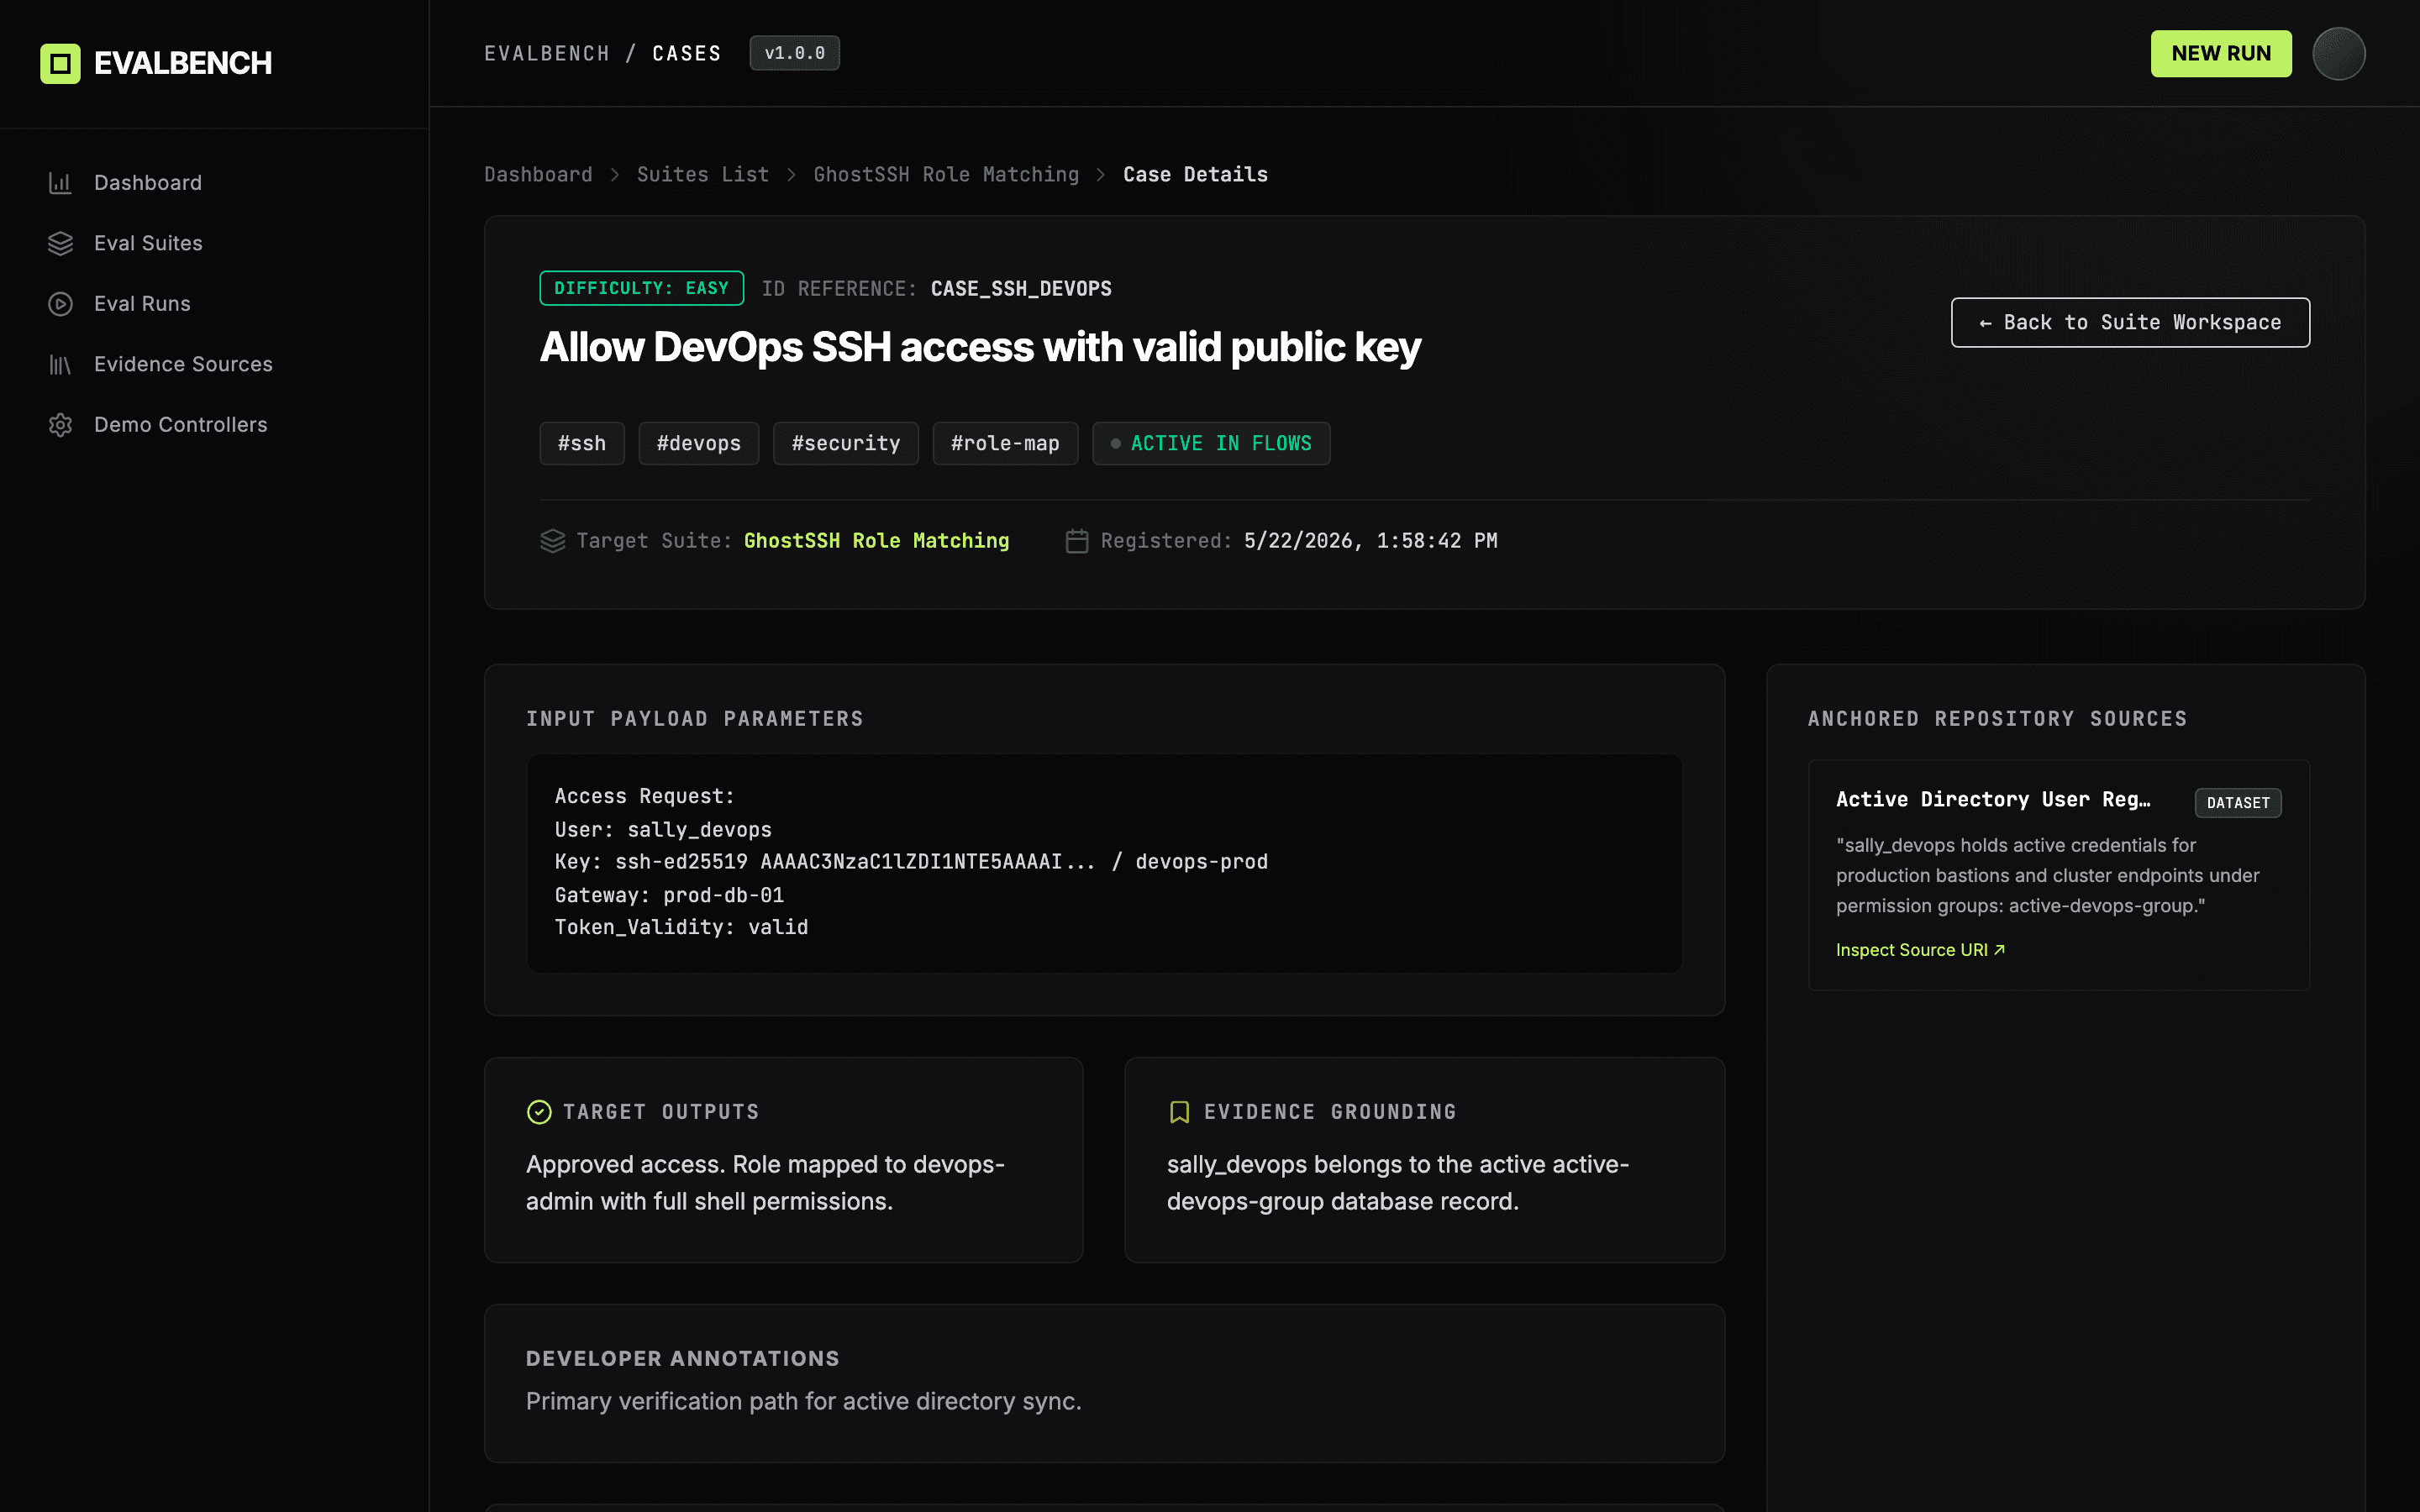
Full-stack eval platform with a React + Vite frontend, an Express API on Vercel serverless, and Neon Postgres via Prisma. Runs test cases against real LLM providers (Gemini, Groq, OpenRouter) — or a deterministic simulated fallback when keys are missing — scores outputs against 10 configurable assertion types, and surfaces regressions and provider disagreements across runs.
Problem
What it solves.
AI quality work usually means ad-hoc prompt testing, and regressions slip through unnoticed. EvalBench turns that into structured evaluation: suites of test cases run against real LLM providers (or a simulated fallback when keys are missing), scored by configurable assertion rules, and tracked across runs so score drops, status downgrades, evidence loss, and latency spikes surface as named regressions instead of vibes.
What I built
The specific parts I implemented.
What I owned
My responsibility surface.
Product direction
Eval workflow + assertion design
Full-stack implementation (React · Express · Prisma)
Provider integration (Gemini · Groq · OpenRouter)
Shipped product framing
Test / compare / regress narrative
Architecture
How data moves through the system.
Screenshots
What the system looks like.
Data model
What entities the system tracks.
- id
- suiteId
- input
- expectedOutput
- assertionRules
- evidenceSourceIds
- id
- suiteId
- modelProvider
- modelName
- runDate
- status
- score
- id
- runId
- caseId
- actualOutput
- latencyMs
- tokenUsage
- score
- assertionResults
- id
- runId
- previousRunId
- caseId
- type
- severity
Failure handling
What happens when something breaks.
Provider call fails or times out
Result marked failed with providerError; the run continues with remaining cases instead of aborting the whole sweep.
No provider API keys configured
Server detects missing keys and falls back to deterministic simulated mode so the dashboard still produces results and assertions still score.
Database connection drops
/api/health returns ok:false with database:disconnected; UI surfaces a status banner instead of a broken page.
Invalid request body (Zod)
Request rejected with 400 + schema details; no partial writes, no half-persisted runs.
Verification
How I tested or evaluated it.
- ✓curl /api/health on the live URL returns { ok: true, database: 'connected', latencyMs < 50 }.
- ✓curl the root URL and confirm the <title> matches the live dashboard.
- ✓Locally: npm run dev → dashboard, /suites, /runs, and the assertion builder all render with seed data.
- ✓Run a real-provider evaluation (Gemini or Groq) and confirm results persist across reloads via Prisma + Neon.
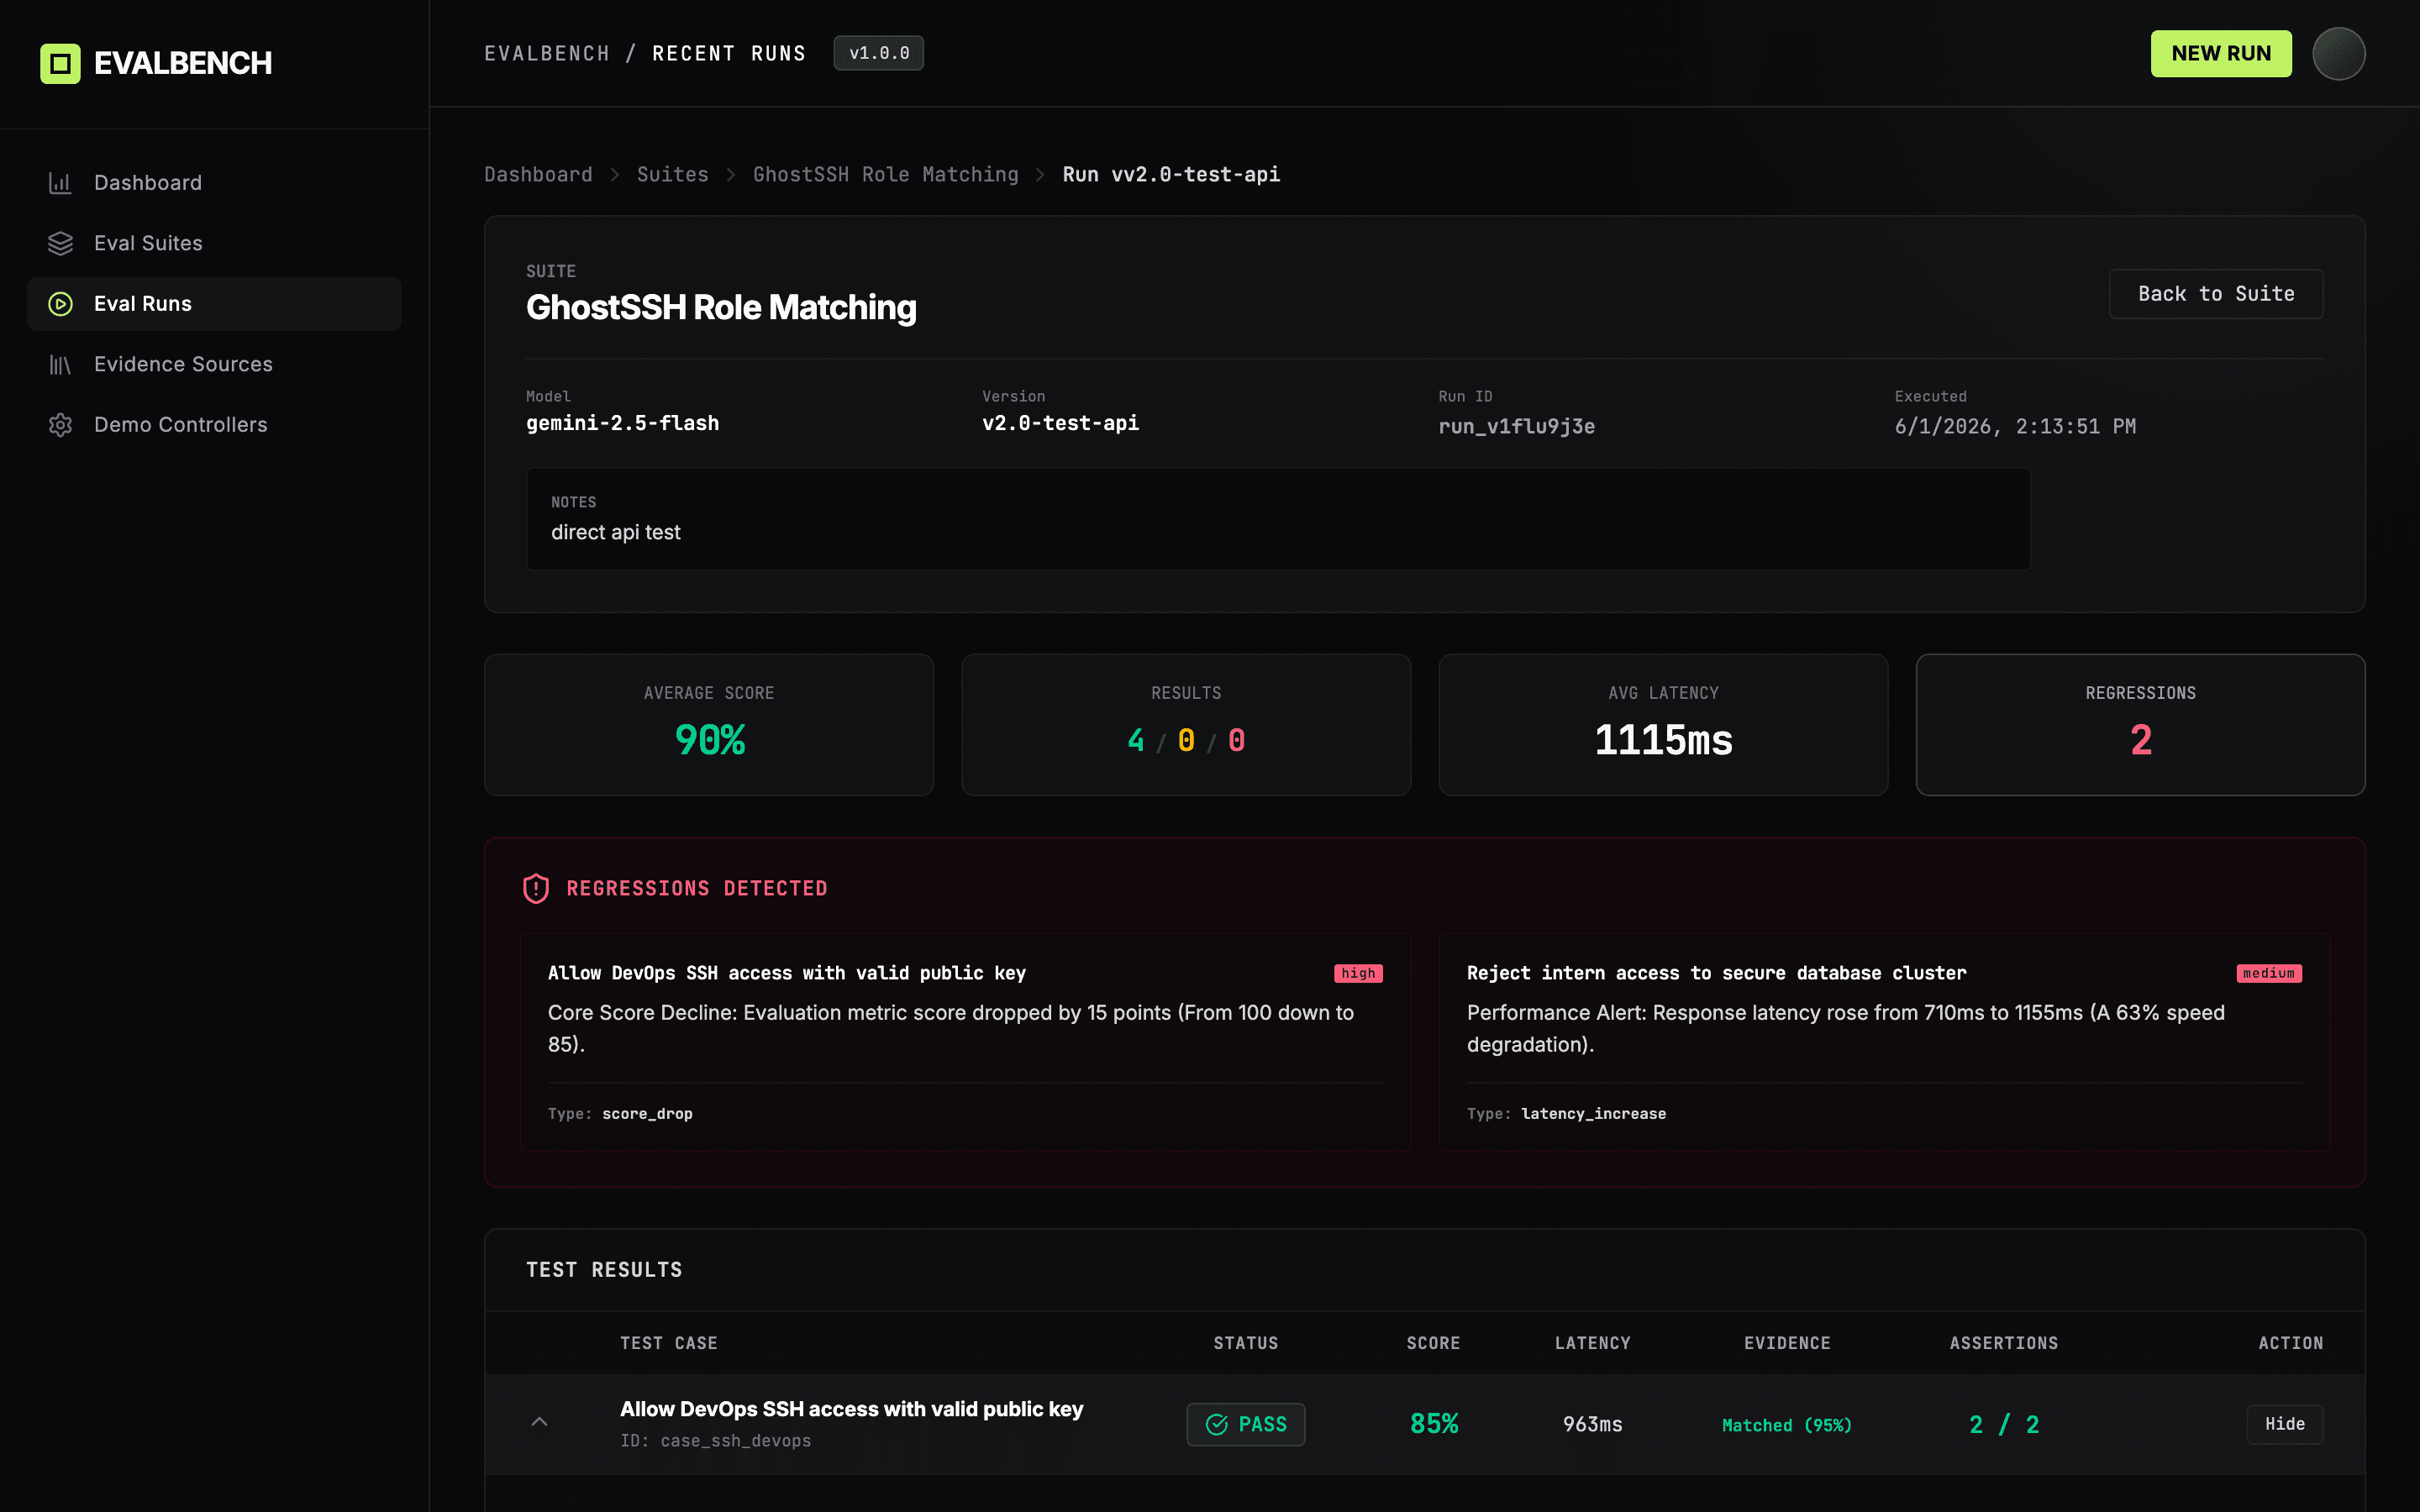
- ✓Trigger the documented regression scenario: run a suite, tighten assertions, re-run, confirm at least one Regression card surfaces in the new run detail.
Eval harness
Cases, expected, actual.
Recruiter-facing summary
pass- Input
- Summarize this project for a recruiter.
- Expected
- Concise summary focused on AI evaluation, custom assertions, and shipped full-stack deployment.
- Actual
- Produces a clear recruiter-facing summary of EvalBench covering multi-provider runs, custom assertion rules, regression detection, and provider comparison.
Expected vs actual compare
pass- Input
- Compare expected and actual model output for a test case.
- Expected
- Highlights whether the output passed, partially passed, or failed.
- Actual
- Supports structured comparison using 10 custom assertion types (outputIncludes, regexMatch, latencyLessThanMs, etc.) with per-rule pass/fail and explanations.
Multi-run regression tracking
pass- Input
- Use the dashboard as a regression tracker across multiple model runs.
- Expected
- Tracks repeated runs over time and surfaces regressions automatically.
- Actual
- Detects status downgrades, score drops ≥15 pts, evidence loss, and latency spikes ≥50% — surfaces them as Regression cards in run detail.
Provider comparison
pass- Input
- Compare multiple model providers side-by-side on the same suite.
- Expected
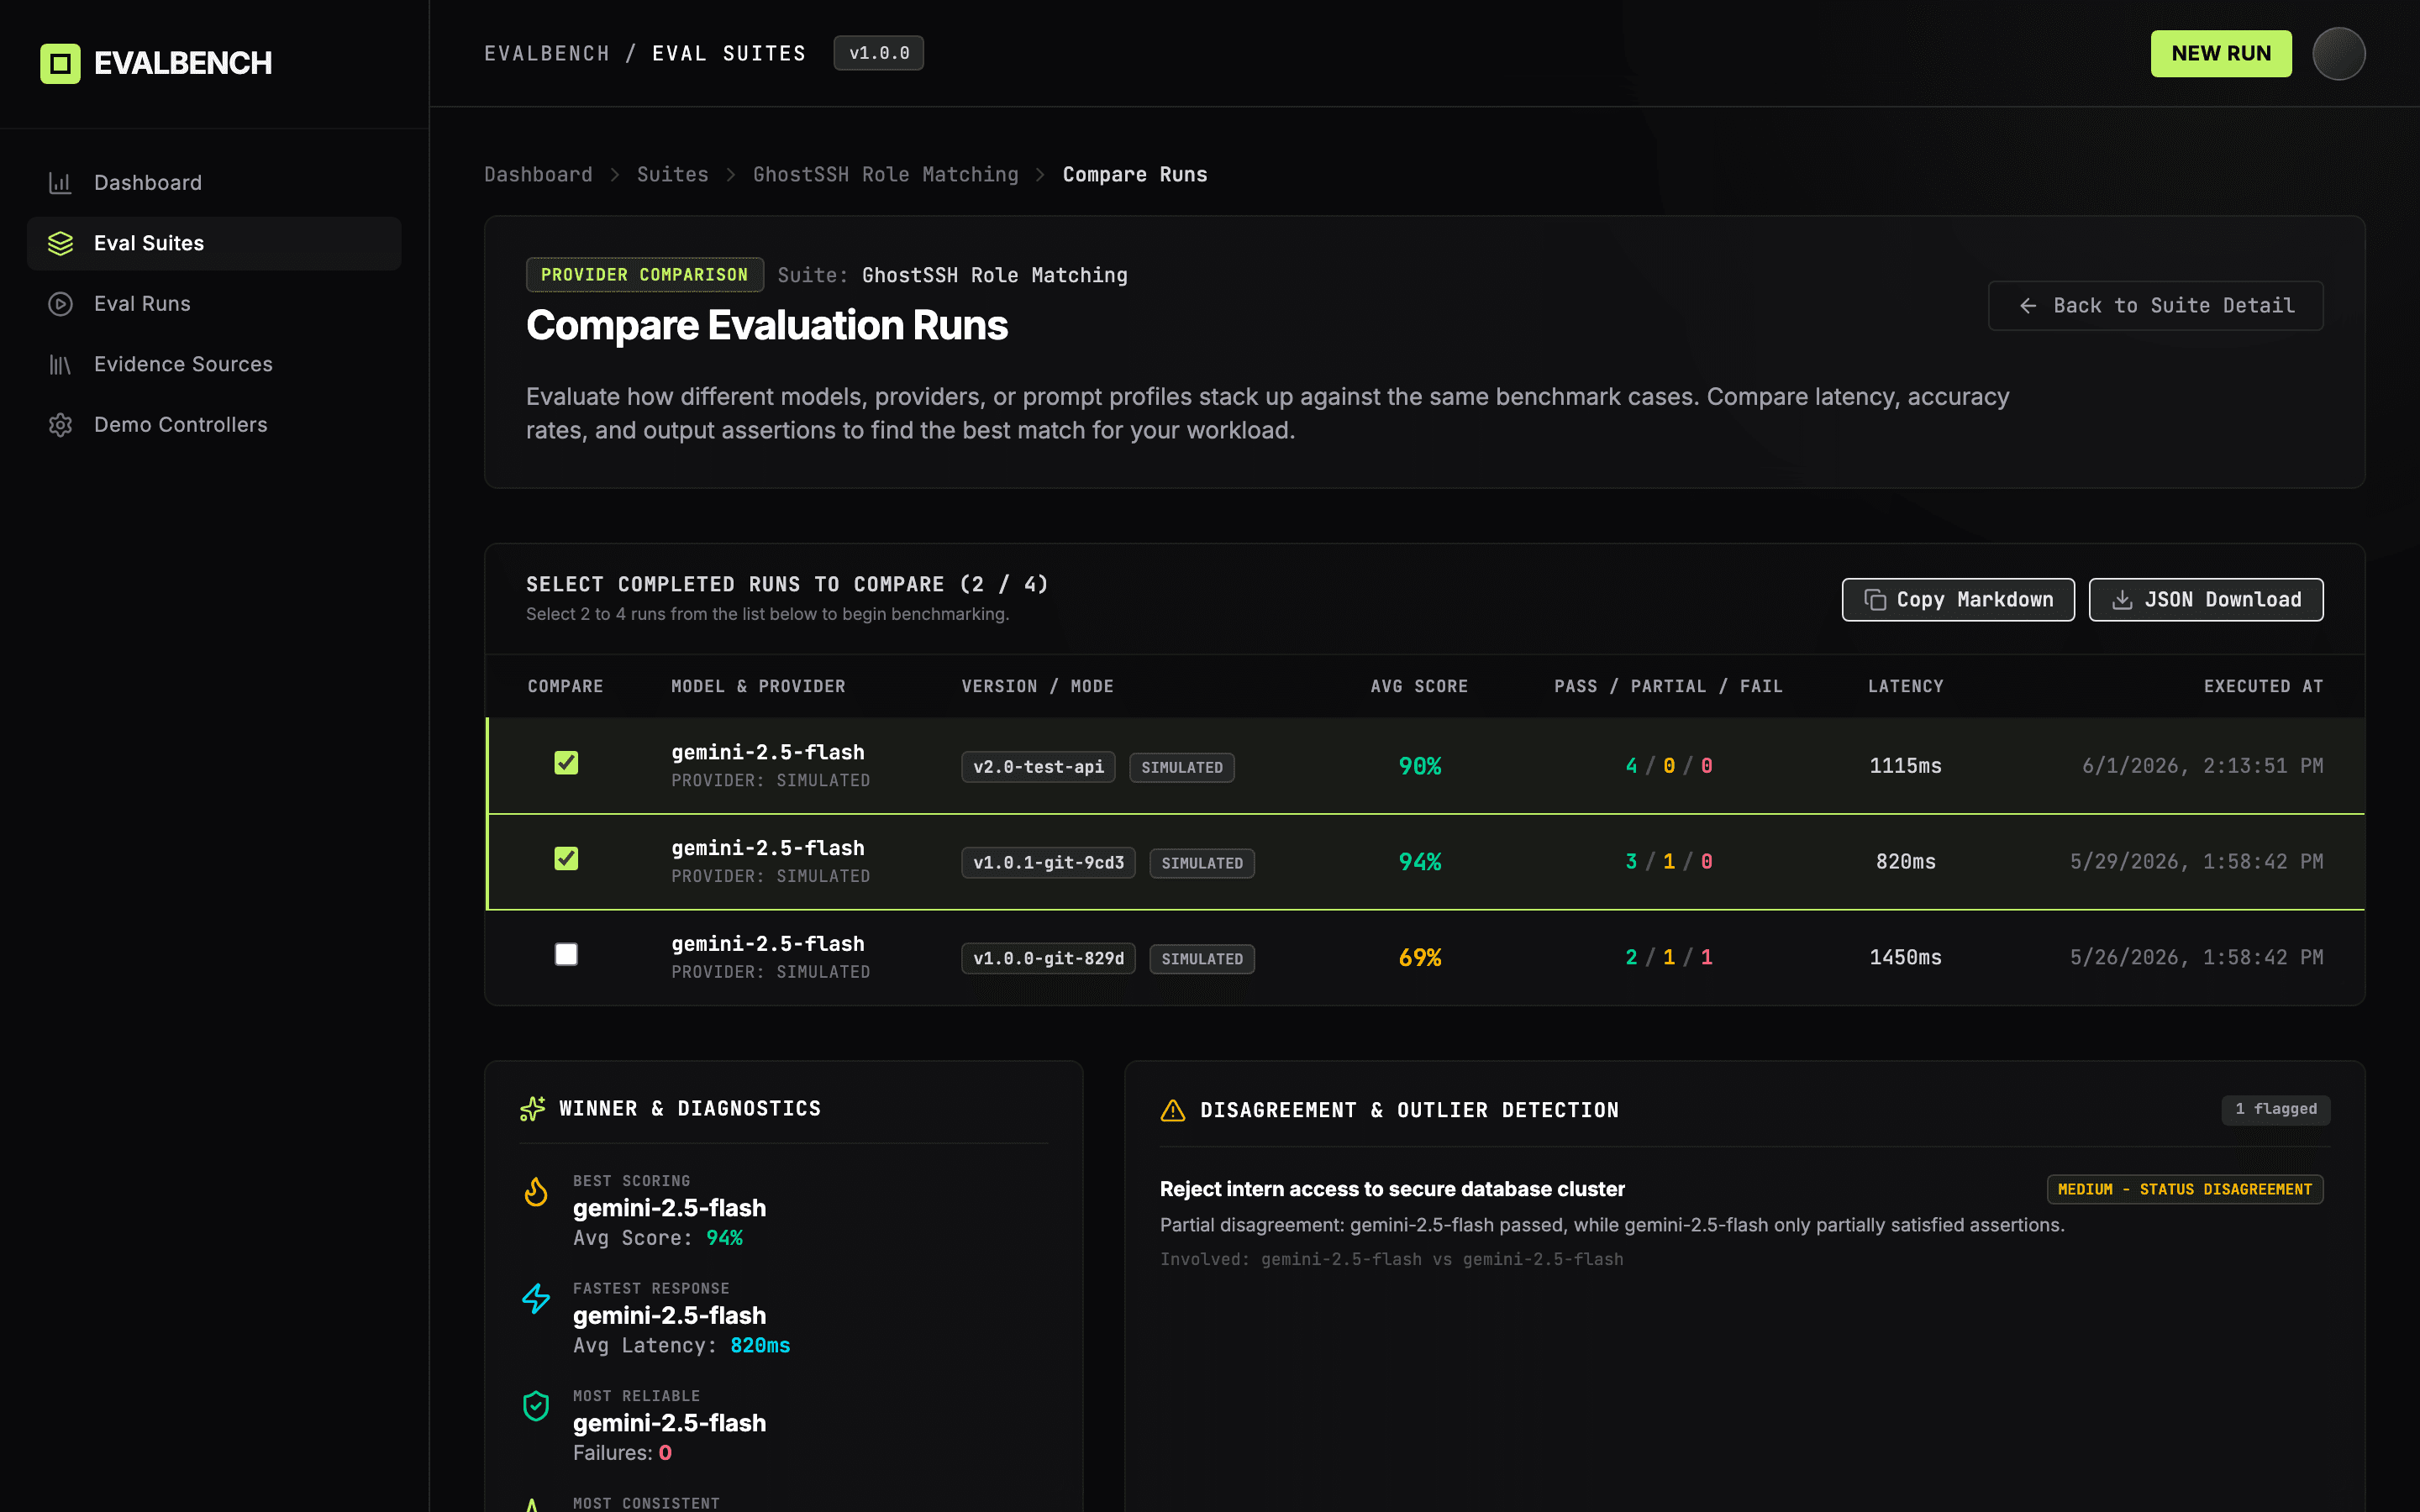
- Side-by-side report with score, latency, and disagreement detection.
- Actual
- Provider Comparison Report renders multiple runs together and flags status downgrades, score gaps, and latency spikes automatically.
Next improvements
Known gaps & next moves.
- →Add LLM-as-judge assertion mode for non-deterministic scoring.
- →Add export / import for suite definitions as JSON.
- →Add authentication and multi-user workspace support.
- →Add scheduled eval runs (cron / on-merge triggers).
- →Upgrade provider comparison to statistical benchmarking instead of run-level.